

Usar un modelo local
Un modelo local se ejecuta en tu propio PC mediante Ollama o LM Studio. Funciona sin conexión, no necesita clave de API y no tiene coste por palabra. La velocidad y la calidad dependen de tu hardware y del modelo.
Inicia el servidor
Ollama suele ejecutarse en segundo plano después de instalarlo. En LM Studio, carga un modelo e inicia su servidor local.
Conecta RuneTranslate
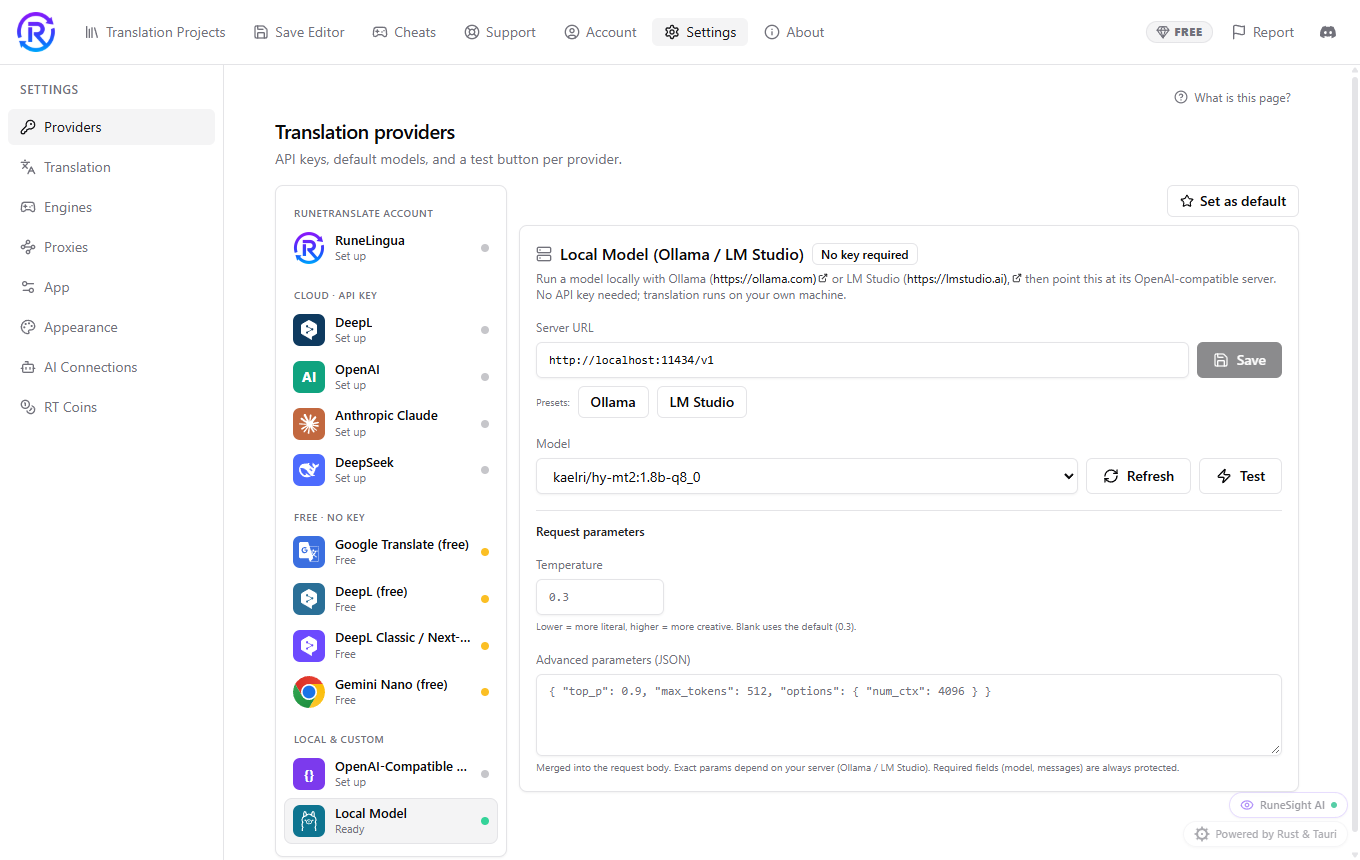
Ve a Configuración, Proveedores, Local Model. En Preajustes, elige Ollama o LM Studio para rellenar la URL del servidor.
Elige un modelo
Pulsa Actualizar para cargar los modelos instalados y elige uno en Modelo.
Pruébalo
Pulsa Probar para enviar una solicitud mínima a tu modelo. La primera puede tardar, porque el modelo tiene que cargarse. Cuando funciona, un mensaje muestra el resultado y el servicio indica Ready.
Úsalo
En tu proyecto, elige Local Model (Ollama / LM Studio) en el menú de la parte superior del editor.
Los ajustes preestablecidos usan estas direcciones:
| Servidor | URL del servidor |
|---|---|
| Ollama | http://localhost:11434/v1 |
| LM Studio | http://localhost:1234/v1 |
Si no se conecta
- No se pudo conectar con el servidor: Ollama o LM Studio no se está ejecutando, o la URL es incorrecta.
- No se encontraron modelos: el servidor se está ejecutando, pero no hay ningún modelo instalado o cargado.
Revisado con RuneTranslate 1.4.6.
¿Sigues atascado?
Pulsa Reportar en la parte superior de la aplicación para enviarnos un ticket, o pregunta en nuestro Discord. Leemos ambos.