

ローカルモデルを使う
ローカルモデルは、Ollama または LM Studio を通じてお使いの PC で動作します。オフラインで使え、API キーは不要で、文字数ごとの料金もかかりません。速度と品質は、ハードウェアとモデルによって変わります。
サーバーを起動する
Ollama は通常、インストール後にバックグラウンドで動作します。LM Studio では、モデルを読み込んでローカルサーバーを起動します。
RuneTranslate につなぐ
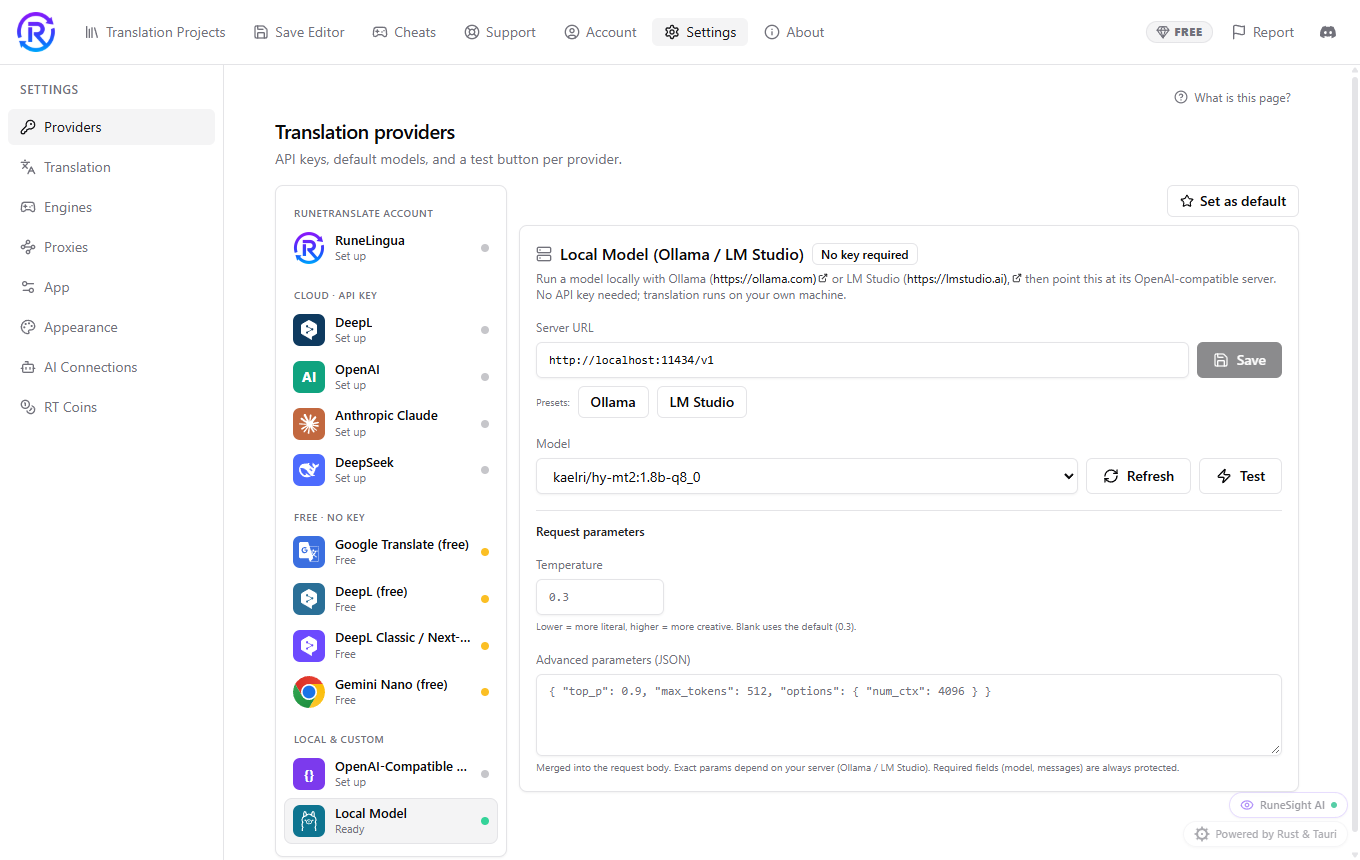
設定、プロバイダー、Local Model を開きます。プリセット で Ollama か LM Studio を選ぶと、サーバー URL が入力されます。
モデルを選ぶ
更新 をクリックしてインストール済みのモデルを読み込み、モデル で 1 つ選びます。
テストする
テスト をクリックして、モデルにごく小さなリクエストを送ります。モデルの読み込みが必要なため、最初の 1 回は時間がかかることがあります。成功するとメッセージで結果が表示され、サービスに Ready と表示されます。
使う
プロジェクトで、エディター上部のメニューから Local Model (Ollama / LM Studio) を選びます。
プリセットでは次のアドレスを使います。
| サーバー | サーバー URL |
|---|---|
| Ollama | http://localhost:11434/v1 |
| LM Studio | http://localhost:1234/v1 |
接続できない場合
- サーバーに到達できませんでした: Ollama か LM Studio が起動していないか、URL が間違っています。
- モデルが見つかりません: サーバーは起動していますが、インストールまたは読み込み済みのモデルがありません。
RuneTranslate 1.4.6 で確認済みです。
解決しませんか?
アプリ上部の「報告」をクリックしてチケットを送るか、Discord でお尋ねください。どちらも目を通しています。