

EnginesGuiasDocsFAQPatreonDiscordBaixar
Entrar

RuneTranslate · traduza jogos do japonês e de 30+ idiomas

Produto

  • Baixar
  • Engines
  • Texto em imagens
  • Editor de saves
  • Modo Cheat
  • Alterações

Recursos

  • Guias
  • Docs
  • Comparar
  • FAQ

Comunidade

  • Patreon
  • Discord
  • YouTube
  • Trustpilot

Legal

  • Privacidade
  • Termos
  • Reembolsos
  • Contato
© 2026 RuneTranslate
Documentação

Primeiros passos

  • O que é o RuneTranslate
  • Requisitos do sistema
  • Instalar no Windows
  • Instalar no Linux
  • Entrar
  • Sua primeira tradução

Tradutores

  • Escolha um tradutor
  • Adicionar uma chave de API
  • Usar um modelo local
  • Modos de execução e novas tentativas

Exportar e compartilhar

  • Exportar um jogo traduzido
  • Compartilhar um patch

Solução de problemas

  • O jogo traduzido não inicia
  • O texto traduzido aparece como quadradinhos
  • Requer uma chave de API
  • Não é possível traduzir para este idioma
  • DeepL gratuito está recusando requisições
  • Nenhum motor suportado detectado
  • Limite de projetos atingido
  • Projeto grande demais para abrir
  • Pasta do jogo não encontrada
  • Execuções diárias esgotadas
  • Atualização necessária
  • Aviso do SmartScreen
  • Janela preta ou em branco
  • Recursos pagos bloqueados
  • Relatar um problema
RuneTranslateDocumentaçãoUsar um modelo local

Use um modelo local

Um modelo local roda no seu próprio PC por meio do Ollama ou do LM Studio. Funciona offline, não precisa de chave de API e não tem custo por palavra. A velocidade e a qualidade dependem do seu hardware e do modelo.

1

Instale um servidor local

Instale o Ollama ou o LM Studio e baixe um modelo com ele.

2

Inicie o servidor

O Ollama costuma rodar em segundo plano depois de instalado. No LM Studio, carregue um modelo e inicie o servidor local dele.

3

Conecte o RuneTranslate

Vá em Configurações, Provedores, Modelo local. Em Predefinições, escolha Ollama ou LM Studio para preencher a URL do servidor.

4

Escolha um modelo

Clique em Atualizar para carregar os modelos instalados e escolha um em Modelo.

5

Teste

Clique em Testar para enviar uma requisição minúscula ao seu modelo. A primeira pode demorar, porque o modelo precisa carregar. Quando funcionar, uma mensagem mostra o resultado e o serviço mostra Ready.
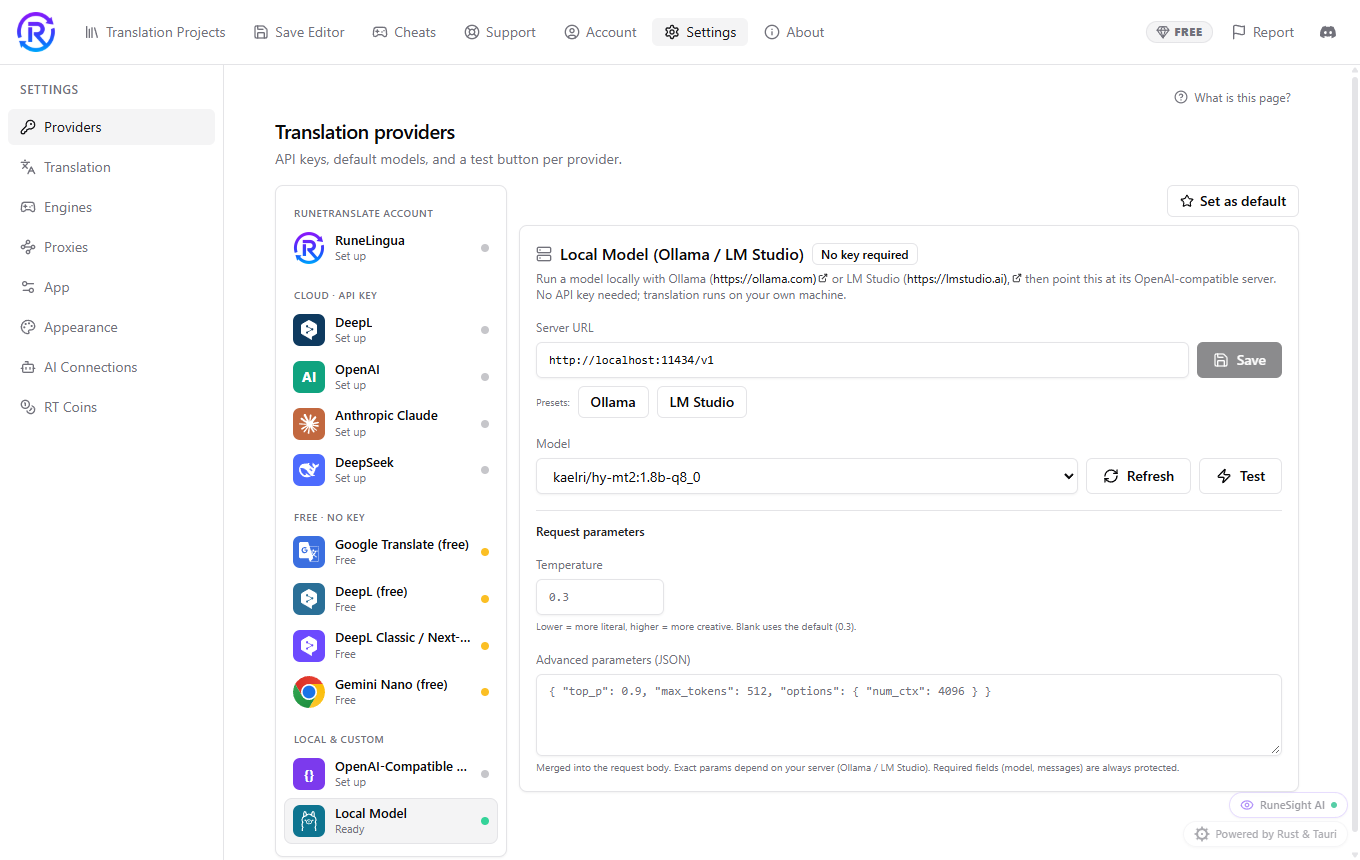
As configurações do Modelo local com a URL do servidor do Ollama, um modelo selecionado e os botões Atualizar e Testar.
6

Use

No seu projeto, escolha Modelo local (Ollama / LM Studio) no menu no topo do editor.

As predefinições usam estes endereços:

ServidorURL do servidor
Ollamahttp://localhost:11434/v1
LM Studiohttp://localhost:1234/v1

Se não conectar

  • Não foi possível alcançar o servidor: o Ollama ou o LM Studio não está rodando, ou a URL está errada.
  • Nenhum modelo encontrado: o servidor está rodando, mas nenhum modelo está instalado ou carregado.

Verificado com o RuneTranslate 1.4.6.

Ainda travado?

Clique em Reportar no topo do aplicativo para nos enviar um ticket, ou pergunte no nosso Discord. Lemos os dois.

AnteriorAdicionar uma chave de APIPróximaModos de execução e novas tentativas